
바쁜 분은 이것만
- 먼저 0원·1원 아이템을 거르기 — 안 거르면 Top 5가 전부 잡음이에요
- 기준일 대비 변동률은 싼 아이템·하루 튀는 값에 약해요
- 최근 7일 평균 ÷ 이전 7일 평균으로 비교하면 Top 5가 훨씬 그럴듯해져요
로스트아크 오픈API 거래소 시세 매일 자동 수집하기에서 만든 스크립트가 10월 1일부터 매일 CSV를 쌓고 있어요. 지금까지는 카테고리 하나씩 한 달 변화를 봤는데, 이번에는 전체 아이템 중에서 최근에 크게 오르거나 내린 것을 자동으로 뽑아 봅니다. pandas 없이 표준 csv 모듈만 써요.
1. 데이터 모양 확인
CSV는 하루에 아이템 한 줄씩이고, 열은 이렇게 생겼어요.
date,category,name,grade,bundle,yday_avg,recent,current_min
2026-10-01,강화 재료,에스더의 기운,에스더,1,1827802.1,1829000,1829998
2026-10-01,강화 재료,재봉술 : 쇠락 [16-19],고대,1,0.0,1,1yday_avg: 전일 평균 거래가. 실제로 거래된 값이라 이걸 가격으로 씁니다.recent,current_min: 최근 거래가, 지금 최저가. 한 건만 올라와도 바뀌어서 이번 분석에서는 안 써요.- 두 번째 줄처럼
yday_avg가 0.0이면 전날 거래가 없었다는 뜻이에요.
같은 이름이 등급만 다르게 두 번 나오는 아이템도 있어서(예: 혼돈의 젬 영웅·희귀) 키는 (카테고리, 이름, 등급) 세 개로 잡았어요.
2. 아이템별 날짜→가격 사전 만들기
import csv, datetime as dt
from collections import defaultdict

PATH = "lostark/data/market_history.csv"
BASE = "2026-10-01"                     # 기준일
RECENT = ("2026-11-01", "2026-11-07")   # 최근 7일
BEFORE = ("2026-10-25", "2026-10-31")   # 이전 7일
MIN_PRICE = 10                          # 평균가가 이보다 싸면 제외 (1~2골드 아이템)

price = defaultdict(dict)   # (카테고리, 이름, 등급) -> {날짜: 전일 평균가}
for r in csv.DictReader(open(PATH, encoding="utf-8")):
    key = (r["category"], r["name"], r["grade"])
    price[key][r["date"]] = float(r["yday_avg"])   # 같은 날 두 줄이면 뒤 줄로 덮어씀

days = sorted({d for p in price.values() for d in p})
print(f"아이템 {len(price)}개 / 수집일 {len(days)}일 ({days[0]} ~ {days[-1]})")
아이템 207개 / 수집일 34일 (2026-10-01 ~ 2026-11-07)10/1~11/7은 38일인데 34일만 있어요. 10/2·10/7·10/14·10/24는 수집이 빠진 날입니다(빠진 이유는 launchd 재시도 글에 정리). 날짜를 사전의 키로 두면 빠진 날은 그냥 없는 키라서, 리스트 인덱스로 "n번째 날"을 셀 때처럼 날짜가 밀리는 일이 없어요. 10/1은 두 번 수집돼 줄이 두 개지만 값이 같아서 덮어써도 괜찮았습니다.
3. 0원·1원 아이템 걸러내기
먼저 아무것도 거르지 않고 아래 5번에서 쓸 7일 평균 비교를 돌려 봤어요(nofilter.py). 이전 7일 평균이 0이면 나눌 수 없어서 그것만 건너뛰었습니다.
이전 7일 평균이 0이라 나눌 수 없는 아이템: 14
질서의 젬 : 견고 (고급)             0.3 →   1800.3  +540002.9%
질서의 젬 : 불변 (고급)             1.7 →   2381.7  +138831.7%
질서의 젬 : 안정 (고급)             0.3 →     50.4  +17530.0%
야금술 : 몽환 [13-15] (유물)       0.1 →      3.0  +2000.0%
혼돈의 젬 : 왜곡 (고급)             0.1 →      1.6  +985.0%
평균이 0.1~1.7골드, 즉 일주일 내내 거래가 거의 없던 아이템이 위를 다 차지했어요. 0에 가까운 값으로 나누면 몇만 %가 나오니 당연한 일입니다. 그래서 두 가지를 뺐어요.
rows, dropped = [], defaultdict(int)
for key, p in price.items():
    if any(v == 0 for v in p.values()):
        dropped["거래 없는 날(0) 있음"] += 1; continue
    if min(p.values()) < MIN_PRICE:
        dropped[f"{MIN_PRICE}골드 미만"] += 1; continue
    if BASE not in p or days[-1] not in p:
        dropped["기준일·마지막 날 값 없음"] += 1; continue
    ...
print("걸러낸 아이템:", dict(dropped))
print("남은 아이템:", len(rows))
걸러낸 아이템: {'거래 없는 날(0) 있음': 51, '10골드 미만': 60}
남은 아이템: 96207개 중 111개가 빠지고 96개만 남았어요. 생각보다 거래가 거의 없는 아이템이 많습니다. 10골드 기준은 정하기 나름이고, 1~2골드짜리는 1골드만 바뀌어도 50~100%가 되니 그보다 넉넉하게 잡았어요.
4. 방법 ①: 기준일 대비 변동률
가장 단순한 건 (마지막 날 ÷ 기준일 − 1) × 100이에요. 10/1과 11/7을 비교해 줄을 세우면 이렇게 나옵니다.
"from_base": (p[days[-1]] / p[BASE] - 1) * 100,[참고] 기준일(10/01) 대비만으로 줄 세우면
유물 정밀 단도 각인서 170.7 → 4,938.9 +2793.3%
유물 폭발물 전문가 각인서 24.1 → 139.6 +479.3%
유물 강령술 각인서 23.3 → 131.4 +463.9%
유물 약자 무시 각인서 28.1 → 138.5 +392.9%
유물 번개의 분노 각인서 31.0 → 150.8 +386.5%숫자는 화려한데 문제가 두 가지 보여요.
- 2~5위는 기준일 가격이 20~30골드대예요. 시작값이 작으면 조금만 올라도 몇백 %가 됩니다.
- 두 날짜 딱 하루씩만 봐서, 그날 값이 튀었으면 그대로 순위에 들어가요.
1위 정밀 단도 각인서는 진짜로 뛴 게 맞는지, 하루 전과 비교해 가장 크게 바뀐 날을 찾아봤어요(빠진 날은 바로 앞 수집일과 비교).
ds = sorted(p)
best = max(zip(ds, ds[1:]), key=lambda a: abs(p[a[1]] / p[a[0]] - 1))
유물 정밀 단도 각인서: 2026-10-29 281.2 → 2026-10-30 7,359.2 (+2517.1%)
유물 추진력 각인서: 2026-10-29 193.8 → 2026-10-30 484.1 (+149.8%)
단단한 철광석: 2026-11-02 2,705.5 → 2026-11-03 2,317.2 (-14.4%)정밀 단도는 10/30 수집분에서 하루 만에 7,359골드로 뛰었고, 그 뒤 2천~4천 골드대에 머물렀어요. 이렇게 계단처럼 한 번 뛴 경우는 기준일 비교로도 잡히지만, 하루만 튀었다가 돌아온 경우와 구분이 안 됩니다.
5. 방법 ②: 최근 7일 평균 vs 이전 7일 평균
하루 값 대신 일주일 평균끼리 비교하면 튀는 값이 묻히고, "요즘 흐름"이 보여요. 11/1~11/7과 10/25~10/31을 비교했습니다. 두 구간 모두 빠진 날이 없어 7일씩 다 들어갔어요.
def avg(p, start, end):
    vals = [v for d, v in p.items() if start <= d <= end]
    return sum(vals) / len(vals) if vals else 0, len(vals)

    a, na = avg(p, *RECENT)
    b, nb = avg(p, *BEFORE)
    rows.append({ ..., "recent": a, "before": b, "n": (nb, na),
                  "week": (a / b - 1) * 100 })

rows.sort(key=lambda r: r["week"])
show("급등 Top 5", rows[::-1][:5])
show("급락 Top 5", rows[:5])
날짜가 "2026-11-01"처럼 ISO 형식 문자열이라 start <= d <= end로 그냥 비교해도 날짜 순서와 같아요. avg가 날 수(len(vals))도 같이 돌려주게 한 건, 빠진 날이 구간에 들어가면 평균에 쓴 날이 7보다 적어지는 걸 확인하려고요.
[급등 Top 5] 최근 7일 평균 vs 이전 7일 평균
1. 유물 추진력 각인서 (유물, 각인서)  273.3 → 532.6  +94.8%  | 10/01 대비 +123.7%
2. 유물 시선 집중 각인서 (유물, 각인서)  255.3 → 451.8  +77.0%  | 10/01 대비 +299.7%
3. 유물 강령술 각인서 (유물, 각인서)  96.9 → 143.6  +48.2%  | 10/01 대비 +463.9%
4. 유물 정밀 단도 각인서 (유물, 각인서)  1,921.3 → 2,844.5  +48.0%  | 10/01 대비 +2793.3%
5. 유물 긴급구조 각인서 (유물, 각인서)  342.5 → 490.0  +43.1%  | 10/01 대비 +229.6%

[급락 Top 5] 최근 7일 평균 vs 이전 7일 평균
1. 단단한 철광석 (희귀, 생활)  4,050.9 → 2,610.4  -35.6%  | 10/01 대비 +9.0%
2. 장인의 야금술 : 3단계 (유물, 강화 재료)  185.8 → 126.2  -32.1%  | 10/01 대비 -44.1%
3. 아비도스 들꽃 (희귀, 생활)  4,020.3 → 2,741.1  -31.8%  | 10/01 대비 +1.6%
4. 장인의 재봉술 : 4단계 (고대, 강화 재료)  52.6 → 36.5  -30.5%  | 10/01 대비 -55.6%
5. 묵직한 철광석 (고급, 생활)  645.5 → 462.2  -28.4%  | 10/01 대비 +1.8%

평균에 쓴 날 수 (이전, 최근): (7, 7)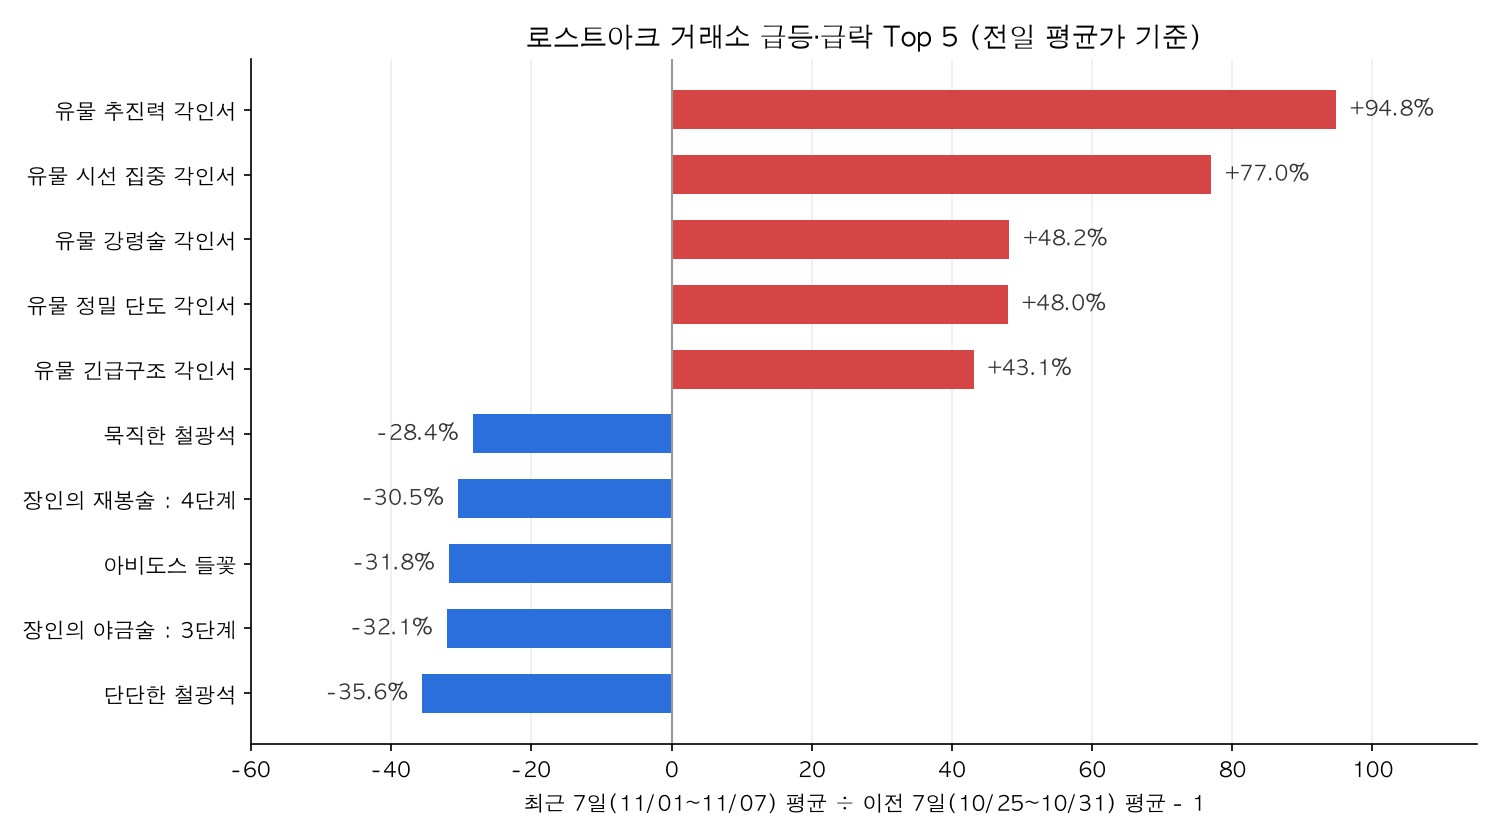
최근 7일(11/1~11/7) 평균과 이전 7일(10/25~10/31) 평균 비교, 전일 평균가 기준 (거래 없는 날이 있거나 10골드 미만인 아이템 제외)
급락 쪽이 특히 재미있어요. 단단한 철광석은 최근 일주일만 보면 −35.6%로 가장 많이 내렸는데, 10/1과 비교하면 오히려 +9.0%예요. 10월 중순부터 4천 골드대까지 올랐다가 다시 내려온 거라, 기준일 비교만 했다면 "거의 그대로"로 보였을 겁니다. 아비도스 들꽃·묵직한 철광석도 같은 모양이에요. 생활 재료의 10월 흐름은 생활 재료 시세 10월 변화 글에서 따로 봤어요.
급등 쪽은 Top 5가 모두 유물 각인서예요. 다만 강령술(96.9 → 143.6)처럼 100골드 근처 아이템은 여전히 퍼센트가 크게 나오기 쉬워서, 실제로 쓸 때는 평균가 하한을 100골드로 올리거나 변동 금액(골드)도 같이 보는 게 좋겠어요. 각인서 전체 흐름은 각인서 시세 10월 한 달 변화, 강화 재료는 강화 재료 시세 10월 추이에 있습니다.
6. 매일 자동으로 돌리려면
RECENT·BEFORE를 손으로 적지 말고 마지막 수집일에서 거꾸로 계산하면, 수집 스크립트 뒤에 붙여 매일 Top 5를 뽑을 수 있어요. 위 nofilter.py가 이 방식으로 구간을 잡았고, 출력 첫 줄이 손으로 적은 값과 같았습니다.
last = dt.date.fromisoformat(days[-1])
RECENT = ((last - dt.timedelta(6)).isoformat(), last.isoformat())
BEFORE = ((last - dt.timedelta(13)).isoformat(), (last - dt.timedelta(7)).isoformat())
RECENT ('2026-11-01', '2026-11-07') BEFORE ('2026-10-25', '2026-10-31')이 경우 구간 안에 빠진 날이 생길 수 있으니, n(평균에 쓴 날 수)이 예를 들어 5보다 작으면 그 아이템은 건너뛰는 조건을 하나 더 넣어 두면 안전합니다.
정리
| 단계 | 방법 | 이 데이터에서 본 점 |
|---|---|---|
| 걸러내기 | yday_avg 0인 날 있음, 10골드 미만 제외 |
207개 → 96개 |
| 빠진 날 | 날짜를 사전 키로, 구간 평균에 쓴 날 수 확인 | 38일 중 34일, 비교 구간은 7일씩 온전 |
| 기준일 대비 | 마지막 ÷ 기준일 − 1 |
싼 아이템이 상위, 오르다 내린 건 안 보임 |
| 7일 평균 비교 | 최근 7일 평균 ÷ 이전 7일 평균 − 1 |
급등 추진력 각인서 +94.8%, 급락 단단한 철광석 −35.6% |
참고: Python 공식 문서 — csv.DictReader, collections.defaultdict, datetime.date.fromisoformat / 로스트아크 오픈API 개발자 문서 — markets